Qwenputer:在 Qwen3.5 权重中编译出可运行的 RISC-V CPU
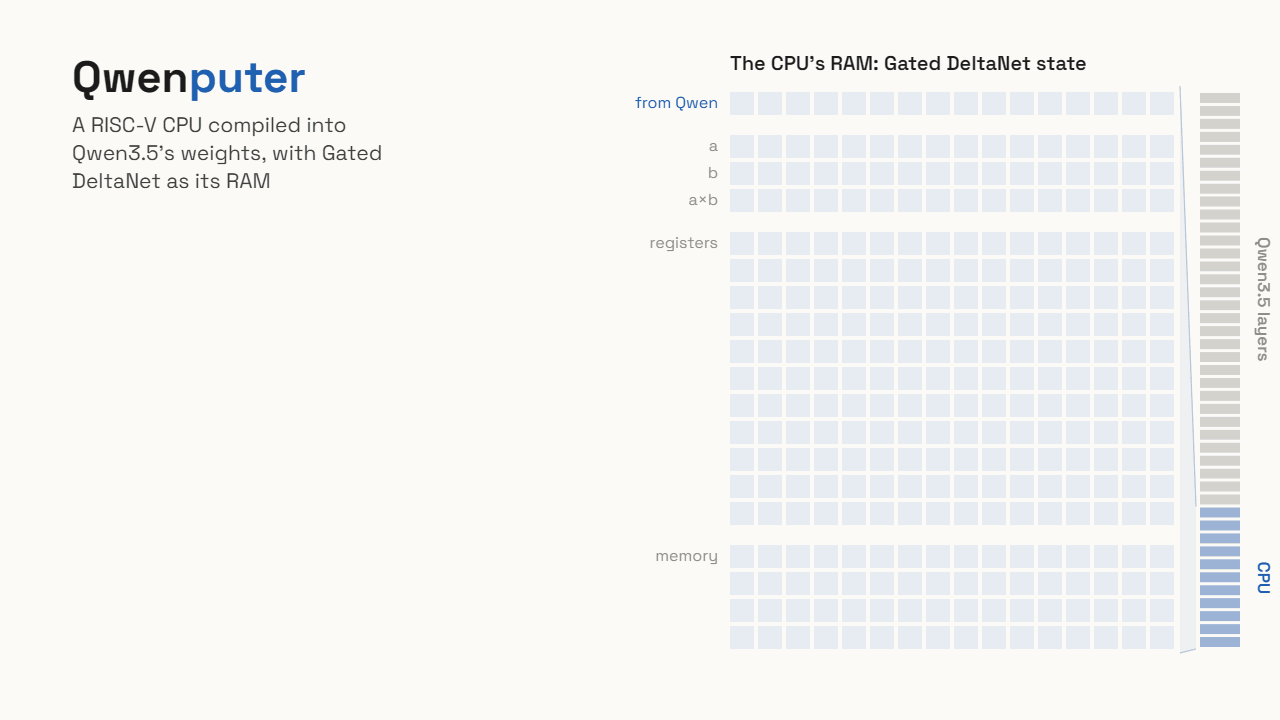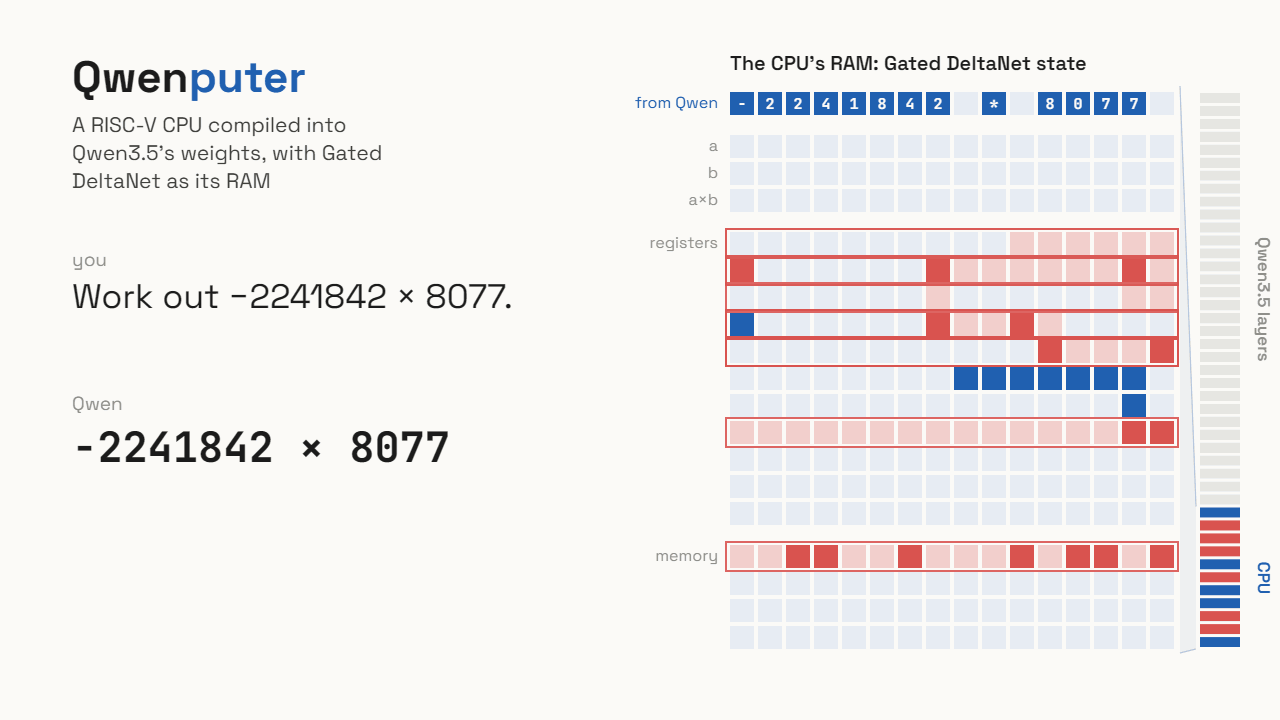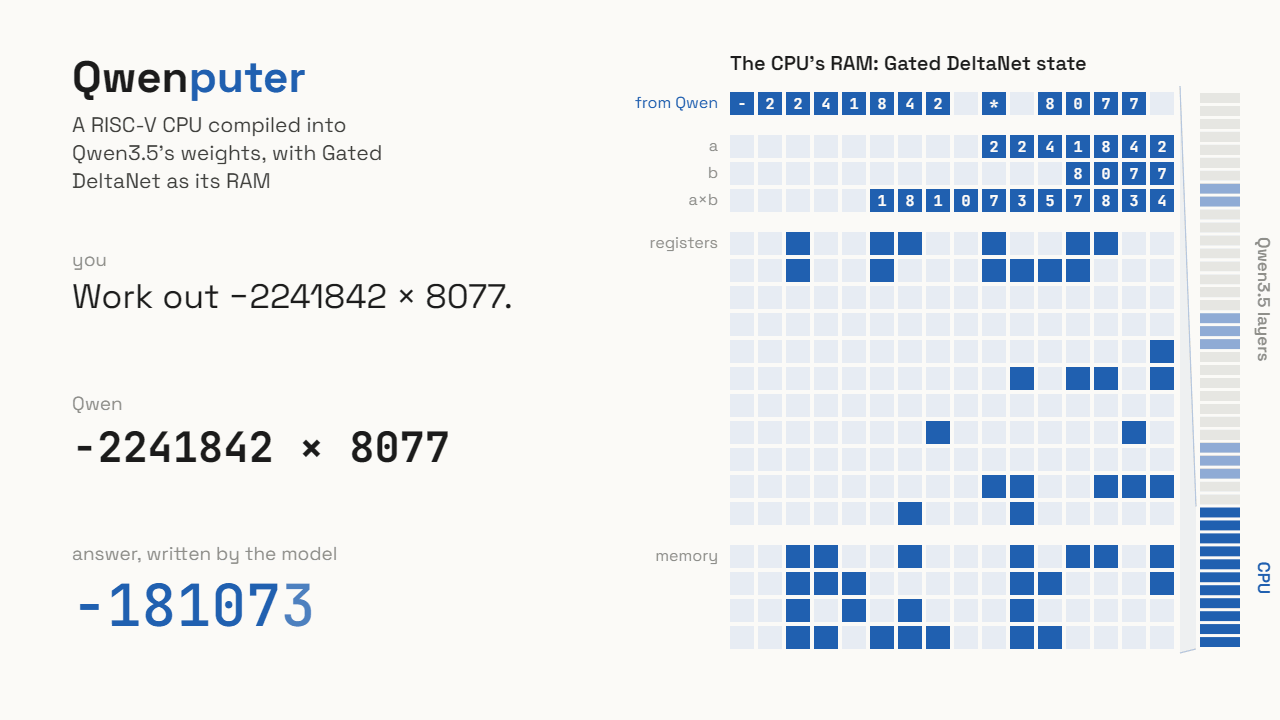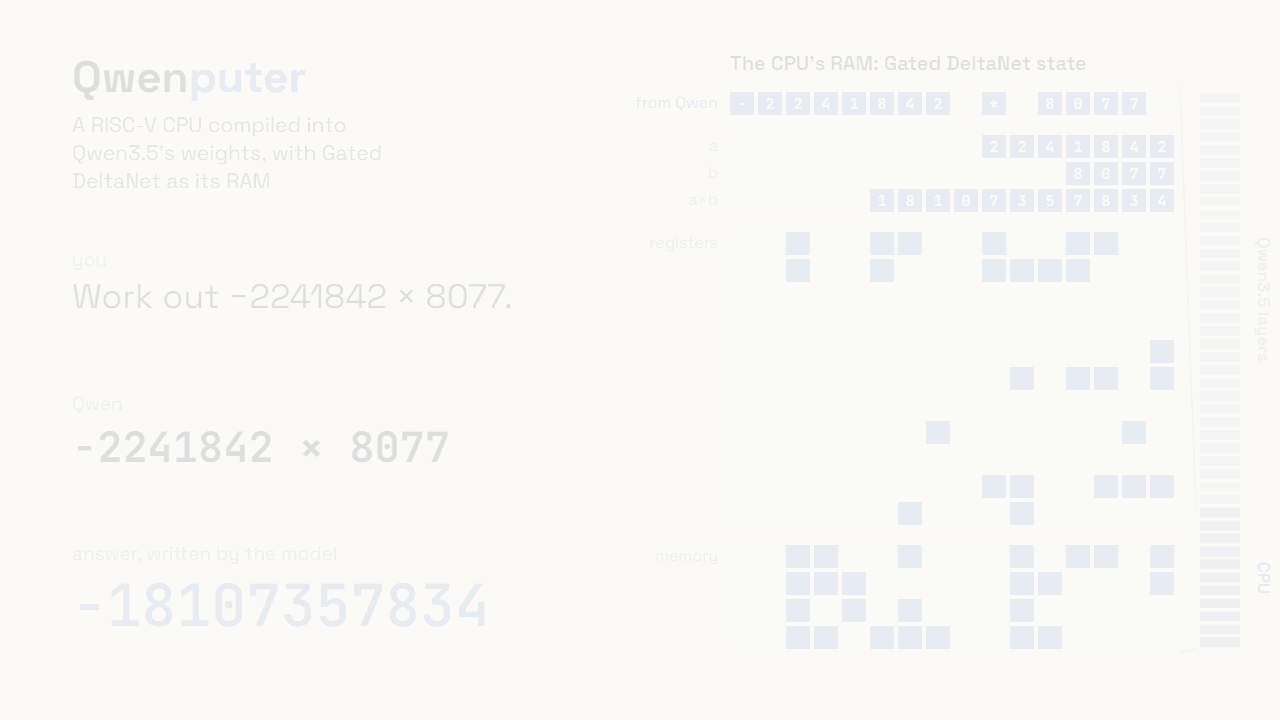
← 我的写作 编译权重 一个原版 Qwen 3.5 4B,其权重中编译进了一个 RISC-V CPU,并运行在自身的 Gated DeltaNet 层上作为 RAM。 我简直不敢相信这不是硅基 Qwenputer 是一个相当有趣的实验性模型。它是一个原版 Qwen 3.5 4B,只增加了一样东西:一个嵌入在权重中的 RISC-V CPU,它使用模型自身的 Gated DeltaNet 注意力层作为 RAM。(要了解 GDN 的工作原理,这里有一份便捷指南。)这个“CPU”完全在模型的前向传播中运行,可以执行算术运算、C 和 MicroPython 代码,无需任何外部运行时或工具使用。 需要非常明确的是,它不是一个插件、工具或沙箱。本博客将准确解释这个模型如何工作,模型如何利用 GDN 层作为 RAM,以及我如何还插入了一个实验性的模型内文件存储。 我还基于 Qwenputer 写了两篇后续文章:混合模型如何学会将推理隐藏在它们的 RNN 状态中以逃避 CoT 监控,以及像这样的编译权重如何作为内置监控工具发挥作用,而模型自身无法篡改它们。 Qwen 将一个乘法交给其自身权重内的 RISC-V CPU;该 CPU 的 RAM 是 Gated DeltaNet 状态 Qwen 将一个乘法交给其自身权重内的 RISC-V CPU;该 CPU 的 RAM 是 Gated DeltaNet 状态 你可以从 Hugging Face 或 ModelScope 获取 Qwenputer,代码在 GitHub 上。 Qwen3.5 内部的 RNN 可以成为精确 RAM Qwen3-Next 和 Qwen 3.5(Qwenputer 所基于的模型)使用了一个相当巧妙的技巧。模型中 4 个注意力层里有 3 个使用 Gated DeltaNet,一种线性 RNN,作为注意力机制(更多内容见此处)。每个头维护一个状态矩阵,delta 规则负责保持其更新。 现在,我们的有趣实验就从这里开始。我发现,通过将门控设为 1,11 每个 Gated DeltaNet 头维护一个状态矩阵,即其记忆。在每个 token 处,在写入任何新内容之前,它会将整个状态乘以门控,一个介于 0 和 1 之间的数。这就是 RNN 遗忘的方式:门控为 0.9 意味着每个 token 上存储的所有内容都会略微衰减,而门控为 1 意味着任何内容都不会衰减。将写入强度(beta)设为 1,22 在门控之后,头会将状态的一个方向推向一个新值,写入强度 beta 设定推动的距离。beta 为 1 意味着沿该方向的旧值被完全替换,而不是混合。并使用 one-hot 键编码,33 一个 one-hot 键是一个除单个 1 外全为零的向量,因此它恰好指向状态的一行,就像内存地址指向一个单元一样。我们执行的每次写入都将恰好覆盖一行,而每个 one-hot 查询都可以检索到一个精确值。这意味着 GDN 层本身可以完全像 RAM 一样工作,成本远低于使用普通注意力作为 RAM,因为无论对话变得多长,GDN 头的状态大小保持不变,而注意力的 KV 缓存则不同。 Gated DeltaNet 状态用作 RAM:一个 one-hot 键覆盖一行,一个 one-hot 查询将其读回,CPU 将它的寄存器、内存和程序计数器保存在这些行中 Gated DeltaNet 状态用作 RAM:一个 one-hot 键覆盖一行,一个 one-hot 查询将其读回,CPU 将它的寄存器、内存和程序计数器保存在这些行中 delta 规则充当记忆这一想法并不新鲜:Schlag 等人(2021)表明,带有 delta 规则的线性注意力可以作为联想记忆,或“快速权重”44 Imanol Schlag、Kazuki Irie 和 Jürgen Schmidhuber,“Linear Transformers Are Secretly Fast Weight Programmers”,ICML 2021。这里的新颖之处在于使其精确且可寻址,在一个生产模型中,可靠到足以在其上运行整个 CPU。 这是整个模型构建的基础。就目前而言,默认的 Qwen 3.5 并不会在 GDN 中保存精确值。通过这一修改,我们解锁了本实验的下一部分。 将一台计算机编译进层中 既然我们现在有了一个功能完整、廉价且快速的 RAM,我们就可以继续将一台可工作的 CPU 编译进模型权重中。幸运的是,这不需要训练:编译器直接设置每一个权重。你将 CPU 描述为一个电路,一长串小步骤,如“读取这个寄存器”、“将这两个数相加”或“若为零则跳转”,编译器将每个步骤转化为 transformer 层的一部分:负责查找的注意力头、负责算术的前馈单元,以及持有 RAM 的 DeltaNet 头。然后 CPU 随着模型解码而运行。 每条指令变成几个生成的 token:一个命名要写入的内存行(ADDR),下一个携带值(VAL),一个 STEP token 结束该指令。这些 token 就是 CPU 的执行轨迹,因此当 Qwen 生成它们时,CPU 实际上正在运行。 CPU 该 CPU 是一个 32 位 RISC-V 核心(RV32IM,加上 Zba 扩展和一个用于大数算术的小型大数单元),它在 Qwen 的 32 层之前占用了 11 层。就目前而言,它通过了官方的 riscv-tests,其程序与 qemu 匹配,并且已经自由运行了 1800 万条指令,没有出现任何错误。55 自由运行意味着 CPU 在整个运行过程中依靠自身的输出持续运行,步骤之间没有参考机器进行纠正。 这个 CPU 还可以在前向传播中相当好地运行 C 和 MicroPython 代码(尽管有点慢)。它还不是 Linux 级别的芯片,但它实现了完整的 RV32IM 指令集。 Qwen 如何使用它 Qwen 3.5 4B 能够相当好地使用这个 CPU,无需任何后训练。该 CPU 完全在内部使用,不通过任何外部工具调用来调用。 为了使模型可靠地使用它,我决定走廉价路线:借助模型训练有素的工具调用格式,Qwen 向 CPU 发送指令并读回结果。不使用任何外部工具调用或运行时。一旦我们的 CPU 接收到指令,计算机层就会运行,然后写入工具响应。我们使用一个名为 RvChat 的小型驱动程序将固件加载到 GDN 状态中,这使轨迹 token 不进入 Qwen 的层。 Qwen 的原始权重保持原样。计算机权重在额外维度和层中添加到它们之上。 它能工作吗? 我认为在读完我喋喋不休的 ranting 之后,你心中主要的问题将是:这真的能工作吗? 基础 Qwen3.5-4B、Qwenputer 以及带 Python 工具的基础 Qwen 在 NUPA 和 DeepMind 算术集上的准确率 基础Qwen3.5-4B、Qwenputer以及配备Python工具的基础Qwen在NUPA和DeepMind算术集上的准确率 在DeepMind数据集上: - div_big:Qwenputer得分为97.5%,而给Qwen 3.5 4B配备Python工具得分为95%,基础Qwen为72.5%。 - mul_big:Qwenputer得分为97.5%,配备Python工具为100%,基础Qwen为55%。 - mul_div_multiple_longer:Qwenputer得分为100%,配备Python工具为97.5%,基础Qwen为90%。 - add_or_sub_big:Qwenputer得分为97.5%,与配备Python工具相同,基础Qwen为87.5%。 在NUPA的长整数算术上,Qwenputer从48.6%提升到100%,与给Qwen配备Python工具相同。 CPU打印出的数字也是精确的:我将约230,000个输出位置与参考机器进行了重放比对,发现零处不匹配。而且给Qwen加装计算机并不会改变它的说话方式:其正常文本与基础Qwen的差异在噪声范围内(KL 6e-4,噪声底为5e-4)。 硬盘?就这经济形势? 因为语言模型里装个CPU显然还不够邪门,我觉得审慎的做法是再给它一个文件系统。 既然我们已经有了一块能用的RAM,这基本上就是小菜一碟。在模型侧,它通过内部的put / append / get / list / delete操作暴露出来。再次强调,没有实际的工具调用。当Qwen“保存”一个文件时,编译后的层会将其名称哈希到DeltaNet状态中维护的目录的1,024个槽位之一,并将文本本身存储在其他头中,每行八个token,链式相连。如果两个名称最终落到同一个槽位,它就会检查下一个。再次找到文件大约需要两三步而不是扫描,它最多可容纳512个文件,大约相当于53,000个token的文本。 有趣的是,这相当持久。你可以在对话结束时保存状态,加载到下一个对话中,文件仍然在那里。使用这个文件系统,Qwen在对话之间变化的事实上正确率达到90%,而粘贴旧对话回去时为30%,并且与给Qwen配备由Python运行的内存工具相当(83.3% vs 78.9%)。这个功能仍处于实验阶段,其代码位于rv-store分支,模型在Hugging Face和ModelScope上。 限制与下一步 Qwenputer很大程度上是一个实验,所以有一些限制。额外的层和更宽的隐藏维度使检查点达到18.8 GB,大约是基础Qwen的两倍,尽管大部分是零填充。它还需要一个小型驱动(RvChat)来启动固件并将跟踪token排除在Qwen的层之外,所以它还不能用普通的generate()调用运行。而且它有点慢,每条CPU指令要花费几个解码token,所以大计算需要几秒而不是几毫秒。我用于基准测试的批处理执行器在L4上每秒运行约3,200个CPU token。 接下来,我希望Qwen能编写Python并在其自身权重内的MicroPython上运行,通过一个python()工具,其工作方式与calc相同。让CPU更快是另一个大目标。 超越算术 对RNN层的精确控制不仅仅对算术有用。它还使Qwenputer成为AI安全研究的绝佳试验台,我写了两篇后续文章:像Qwen 3.5这样的混合模型如何学会将推理隐藏在RNN状态中并逃避CoT监控,以及编译后的权重如何作为可监控性工具,比如模型无法关闭的权重内监控器,或用于可解释性的答案密钥。 试一试 如果你想自己玩一玩,该模型在单个24 GB GPU上运行。你需要uv和Hugging Face CLI。计算不需要工具服务器或Python沙箱:CPU在模型内部运行它们。 git clone https://github.com/divagr18/qwenputer && cd qwenputer/experimental/riscv && uv sync --extra hf hf download divagr1925/Qwen3.5-4B-Qwenputer --local-dir qwenputer-rv uv run python -m chipformer.rv.chat qwenputer-rv --firmware tests/data/rv/calc-bridge.elf \ --ask "Use calc: what is 123456789 * 987654321?" 一切都是开放的:代码在GitHub上,两个模型都在Hugging Face(Qwenputer、Filesystem)和ModelScope(Qwenputer、Filesystem)上。 如果你在工作中使用它,可以这样引用: @software{agrawal2026qwenputer, author = {Agrawal, Divyansh}, title = {{Qwenputer}: a computer compiled into the weights of a pretrained language model}, year = {2026}, url = {https://github.com/divagr18/qwenputer} } 注释 1. 每个门控DeltaNet头维护一个状态矩阵,即其记忆。在每个token处,在写入任何新内容之前,它将整个状态乘以门控,一个介于0和1之间的数字。这就是RNN遗忘的方式:门控为0.9会使每个token上存储的所有内容略微衰减,而门控为1意味着永不衰减。↩ 2. 在门控之后,头将状态的一个方向推向新值,写入强度beta设定推多远。beta为1意味着沿该方向的旧值被完全替换而不是混合。↩ 3. 独热键是一个除单个1外全为零的向量,因此它恰好指向状态的一行,就像内存地址指向一个单元一样。↩ 4. Imanol Schlag, Kazuki Irie and Jürgen Schmidhuber, "Linear Transformers Are Secretly Fast Weight Programmers", ICML 2021. ↩ 5. 自由运行意味着CPU在整个运行过程中基于自己的输出持续运行,步骤之间没有参考机器纠正。↩
